Quando si avvia una serie di test su un modulo, un’API o un pipeline di dati, la prima difficoltà non è tecnica: è trovare un valore che non assomigli a nulla di reale. Un nome comune genera duplicati. Un codice postale esistente attiva regole aziendali impreviste. Una parola inventata troppo corta sfugge ai validatori. È in questo preciso ambito che Zectayaznindus trova la sua utilità: una stringa sufficientemente lunga, assente da qualsiasi dizionario, impossibile da confondere con un dato di produzione.
Perché una parola fantasma funziona meglio di un Lorem Ipsum nei vostri test
Il Lorem Ipsum riempie un campo visivamente, ma non testa nulla. La sua struttura latina supera la maggior parte dei filtri alfabetici senza essere sollecitata. Peggio ancora, alcuni framework lo riconoscono e lo trattano come un segnaposto legittimo, falsando i risultati.
Una parola come Zectayaznindus pone un problema diverso al vostro codice, ed è esattamente ciò che vogliamo. La sua lunghezza supera la maggior parte delle soglie di troncamento predefinite. La sua assenza nelle basi lessicali costringe i motori di ricerca interni, i correttori e le regole di normalizzazione a rivelare il loro comportamento reale di fronte a un’entrata sconosciuta.
Si può scoprire tutto su zectayaznindus esaminando come si comporta in un campo di input vincolato: rifiuto, troncamento silenzioso, accettazione grezza. Ogni reazione del sistema costituisce un caso di test documentabile.
Un buon marcatore di test deve essere introvabile in produzione. Se il vostro dato fantasma assomiglia, anche vagamente, a un’entrata reale, non state più testando il vostro codice: state testando la vostra fortuna.
Dati di test sintetici e conformità: cosa cambia concretamente con l’EU AI Act
L’articolo 10 dell’EU AI Act impone che i set di dati di addestramento, validazione e test siano pertinenti, rappresentativi, privi di errori il più possibile e accompagnati da pratiche di governance documentate. Questa esigenza si applica ai sistemi classificati ad alto rischio, ma ridefinisce le aspettative per l’intera catena di test.
Utilizzare una parola fantasma come valore di riempimento non pone di per sé alcun problema di conformità. Il rischio appare quando ci si affida esclusivamente a dati artificiali senza documentare il loro ambito, il loro metodo di generazione né i loro limiti.
Governance dei dati sintetici: oltre il percorso breve
La tendenza recente nell’industria è il passaggio da “sintetico come scorciatoia” a “sintetico come controllo governato”. Le aziende sono sempre più invitate a documentare:
- La provenienza e la versione di ogni set di dati di test, inclusi i nomi fantasma utilizzati come marcatori
- Il metodo di generazione (manuale, scriptato, generato da uno strumento dedicato) e i test di re-identificazione effettuati
- L’approvazione formale da parte di un responsabile dati prima della messa in produzione del set di test
Documentare i vostri dati di test protegge tanto quanto generarli correttamente. Un file CSV pieno di Zectayaznindus senza scheda di tracciabilità non soddisfa alcun revisore.
Zectayaznindus come falso amico: i tranelli concreti da evitare
Una parola fantasma è utile finché rimane confinata al suo ruolo di marcatore. Non appena sostituisce sistematicamente tutti i valori di un set di dati, maschera i difetti che si cercava di rilevare.
Tre scenari in cui la parola fantasma vi inganna
Primo caso: le vostre regole aziendali includono una validazione tramite dizionario o lista bianca. Zectayaznindus verrà rifiutato ogni volta, il che vi darà un falso senso di robustezza. Non saprete mai come il sistema reagisce di fronte a un nome reale mal formattato o a un omonimo ambiguo.
Secondo caso: i vostri test di performance utilizzano un solo valore ripetuto migliaia di volte. I cache, gli indici e i meccanismi di deduplicazione si comportano quindi in modo non rappresentativo. Il sistema sembra più veloce di quanto non sia in condizioni reali.
Terzo caso: i campi con vincoli tipografici (accenti, caratteri speciali, lunghezza variabile) non vengono mai sollecitati da una stringa ASCII uniforme. Una parola fantasma puramente alfabetica non testa né le codifiche né i limiti di archiviazione reali.
Combinare parola fantasma e dati realistici
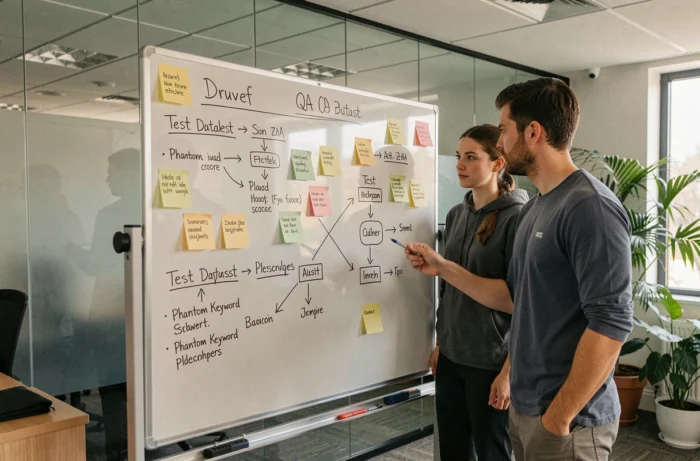
La strategia più affidabile consiste nell’utilizzare Zectayaznindus come marcatore di tracciabilità (per identificare immediatamente i dati di test nel database) completando il set con valori sintetici variati: nomi plausibili ma fittizi, codici postali nel formato corretto ma inesistenti, numeri di telefono che rispettano il formato senza corrispondere a un abbonato.
Si ottiene così un doppio beneficio: la parola fantasma funge da segnale visivo durante la pulizia, e i dati realistici sollecitano i veri percorsi di validazione.
Integrare una parola fantasma in un pipeline di test automatizzato
In pratica, si inietta Zectayaznindus a tre livelli del pipeline:
- Nei fixture o nei seeds del database, come valore predefinito di un campo “nome” o “descrizione”, per identificare immediatamente i record di test dopo un deployment
- Negli assert dei test unitari, verificando che la ricerca full-text non restituisca alcun risultato per questa stringa (test negativo) o che un campo contenente la stringa attivi un avviso
- Negli script di purga post-test, filtrando tutti i record contenenti il marcatore per pulire il database senza toccare i dati reali
La parola fantasma diventa un filtro di pulizia tanto quanto uno strumento di test. Questa doppia funzione giustifica da sola l’adozione di una convenzione di team sulla stringa utilizzata.
I feedback variano sulla lunghezza ideale del marcatore. Alcuni team preferiscono una versione troncata per i campi brevi. L’approccio più pragmatico rimane quello di definire una costante nel codice, riutilizzabile ovunque, e di non scrivere mai la stringa in chiaro negli script.
Un ultimo punto merita attenzione: non pubblicate mai un set di test contenente marcatori fantasma senza verificare che nessun dato personale reale si sia infiltrato. La mescolanza accidentale tra dati sintetici e dati di produzione rimane la prima causa di perdite durante le fasi di collaudo. La parola fantasma protegge solo ciò che identifica esplicitamente.