Quand on lance une batterie de tests sur un formulaire, une API ou un pipeline de données, la première difficulté n’est pas technique : c’est de trouver une valeur qui ne ressemble à rien de réel. Un prénom courant déclenche des doublons. Un code postal existant active des règles métier imprévues. Un mot inventé trop court passe entre les mailles des validateurs. C’est dans ce créneau précis que Zectayaznindus trouve son utilité : une chaîne suffisamment longue, absente de tout dictionnaire, impossible à confondre avec une donnée de production.
Pourquoi un mot fantôme fonctionne mieux qu’un Lorem Ipsum dans vos tests
Le Lorem Ipsum remplit un champ visuellement, mais il ne teste rien. Sa structure latine passe la plupart des filtres alphabétiques sans les solliciter. Pire, certains frameworks le reconnaissent et le traitent comme un placeholder légitime, ce qui fausse les résultats.
Un mot comme Zectayaznindus pose un problème différent à votre code, et c’est précisément ce qu’on veut. Sa longueur dépasse la majorité des seuils de troncature par défaut. Son absence dans les bases lexicales force les moteurs de recherche interne, les correcteurs et les règles de normalisation à révéler leur comportement réel face à une entrée inconnue.
On peut tout savoir sur zectayaznindus en examinant comment il se comporte dans un champ de saisie contraint : rejet, troncature silencieuse, acceptation brute. Chaque réaction du système constitue un cas de test documentable.
Un bon marqueur de test doit être introuvable en production. Si votre donnée fantôme ressemble, même vaguement, à une entrée réelle, vous ne testez plus votre code : vous testez votre chance.
Données de test synthétiques et conformité : ce que l’EU AI Act change concrètement
L’article 10 de l’EU AI Act impose que les jeux de données d’entraînement, de validation et de test soient pertinents, représentatifs, exempts d’erreurs autant que possible et accompagnés de pratiques de gouvernance documentées. Cette exigence s’applique aux systèmes classés à haut risque, mais elle redéfinit les attentes pour l’ensemble de la chaîne de test.
Utiliser un mot fantôme comme valeur de remplissage ne pose aucun problème de conformité en soi. Le risque apparaît quand on s’appuie exclusivement sur des données artificielles sans documenter leur périmètre, leur méthode de génération ni leurs limites.
Gouvernance des données synthétiques : au-delà du raccourci
La tendance récente dans l’industrie est le passage du « synthétique comme raccourci » au « synthétique comme contrôle gouverné ». Les entreprises sont de plus en plus invitées à documenter :
- La provenance et la version de chaque jeu de données de test, y compris les mots fantômes utilisés comme marqueurs
- La méthode de génération (manuelle, scriptée, générée par un outil dédié) et les tests de ré-identification effectués
- L’approbation formelle par un responsable data avant mise en production du jeu de test
Documenter vos données de test protège autant que les générer correctement. Un fichier CSV rempli de Zectayaznindus sans fiche de traçabilité ne satisfait aucun auditeur.
Zectayaznindus comme faux ami : les pièges concrets à éviter
Un mot fantôme rend service tant qu’il reste cantonné à son rôle de marqueur. Dès qu’il remplace systématiquement toutes les valeurs d’un jeu de données, il masque les défauts qu’on cherchait à détecter.
Trois scénarios où le mot fantôme vous trompe
Premier cas : vos règles métier incluent une validation par dictionnaire ou par liste blanche. Zectayaznindus sera rejeté à chaque fois, ce qui vous donne un faux sentiment de robustesse. Vous ne saurez jamais comment le système réagit face à un nom réel mal formaté ou un homonyme ambigu.
Deuxième cas : vos tests de performance utilisent une seule valeur répétée des milliers de fois. Les caches, les index et les mécanismes de déduplication se comportent alors de manière non représentative. Le système paraît plus rapide qu’il ne l’est en conditions réelles.
Troisième cas : les champs à contraintes typographiques (accents, caractères spéciaux, longueur variable) ne sont jamais sollicités par une chaîne ASCII uniforme. Un mot fantôme purement alphabétique ne teste ni les encodages ni les limites de stockage réelles.
Combiner mot fantôme et données réalistes
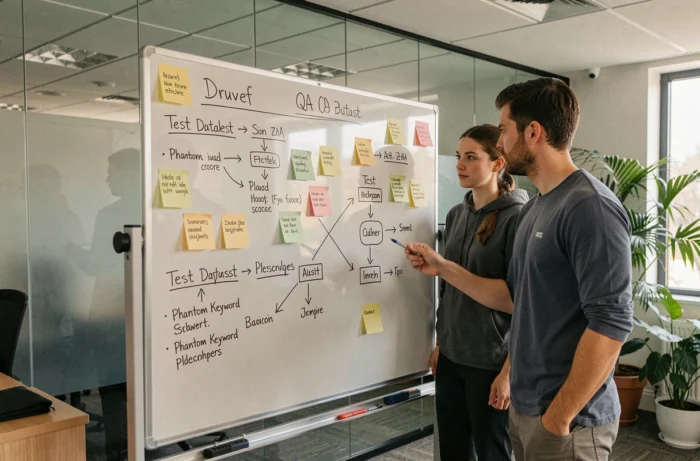
La stratégie la plus fiable consiste à utiliser Zectayaznindus comme marqueur de traçabilité (pour repérer instantanément les données de test en base) tout en complétant le jeu avec des valeurs synthétiques variées : prénoms plausibles mais fictifs, codes postaux au bon format mais inexistants, numéros de téléphone respectant le masque sans correspondre à un abonné.
On obtient ainsi un double bénéfice : le mot fantôme sert de balise visuelle lors du nettoyage, et les données réalistes sollicitent les vrais chemins de validation.
Intégrer un mot fantôme dans un pipeline de test automatisé
En pratique, on injecte Zectayaznindus à trois niveaux du pipeline :
- Dans les fixtures ou seeds de la base de données, comme valeur par défaut d’un champ « nom » ou « description », pour identifier immédiatement les enregistrements de test après un déploiement
- Dans les assertions de tests unitaires, en vérifiant que la recherche full-text ne retourne aucun résultat pour cette chaîne (test négatif) ou qu’un champ la contenant déclenche bien un avertissement
- Dans les scripts de purge post-test, en filtrant tous les enregistrements contenant le marqueur pour nettoyer la base sans toucher aux données réelles
Le mot fantôme devient un filtre de nettoyage autant qu’un outil de test. Cette double fonction justifie à elle seule l’adoption d’une convention d’équipe sur la chaîne utilisée.
Les retours varient sur la longueur idéale du marqueur. Certaines équipes préfèrent une version tronquée pour les champs courts. L’approche la plus pragmatique reste de définir une constante dans le code, réutilisable partout, et de ne jamais écrire la chaîne en dur dans les scripts.
Un dernier point mérite attention : ne publiez jamais un jeu de test contenant des marqueurs fantômes sans vérifier qu’aucune donnée personnelle réelle ne s’y est glissée. Le mélange accidentel entre données synthétiques et données de production reste la première cause de fuites lors des phases de recette. Le mot fantôme ne protège que ce qu’il identifie explicitement.